Серверы и ИИ: практическое применение
STALE и FAILED neighbour cache в мониторинге IPv6
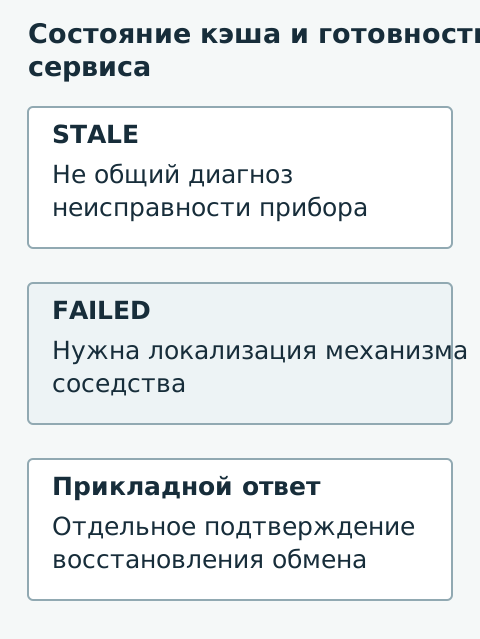
Мониторинг увидел STALE и объявил прибор недоступным, хотя новый запрос проходит. Для хозяйства нужно интерпретировать состояние neighbour cache по документации, а готовность приложения проверять отдельно. Сетевой кэш описывает свой механизм достижимости и не является универсальной диагностикой физического датчика, сервиса или всего пути до центрального архива телеметрии на другой площадке.
Прочитать значение состояния
Linux ip neighbour различает состояния NUD, включая STALE и FAILED. (Linux iproute2 — ip neighbour8) RFC4861 описывает Neighbor Discovery и поддержание достижимости. (IETF — RFC4861 IPv6 Neighbor Discovery) Для своего стека сохраните версию и фактический вывод. Не считайте похожие подписи разных ОС полностью одинаковым контрактом без проверки документации реализации и доступного жизненного контекста наблюдаемого сетевого соседа хозяйства.
Уточните интерфейс, адрес и время наблюдения. STALE не следует механически переводить в общий аварийный статус «устройство сломано». Для FAILED также нужна локализация: отказ подтверждённого механизма соседства не объясняет автоматически питание, физическое состояние прибора или причину отсутствия приложения, если эти сведения отдельно не наблюдались доступным поддерживаемым способом на объекте.
Сопоставить безопасный обмен
Выберите собственный разрешённый узел и чтение без технологического действия. Сохраните состояние до запроса, доступные переходы и фактический ответ. Не очищайте кэш заранее ради красивого результата. Исходное состояние полезно для понимания, как система использует и обновляет запись, когда возникает реальная потребность в новом полезном обмене выбранного приложения хозяйства.
Сравните локальную сетевую проверку и обращение к конечному сервису. Ответ соседа не подтверждает правильный декодер и запись измерения. И наоборот, отсутствие нового значения в архиве не доказывает сетевой отказ, если пакет уже принят обработчиком, который затем отклонил прикладную схему либо обнаружил диагностический статус физического канала конкретного устройства.
Проверить отказ и восстановление
На стенде используйте предусмотренный сценарий временной недоступности узла. Сопоставьте реальные события с состояниями и временем реакции мониторинга. Не назначайте универсальный интервал всем системам. Задержка и последовательность зависят от конфигурации и реализации, поэтому ожидаемое поведение должно быть документировано именно для выбранного оборудования, сети и режима работы пилота хозяйства.
После восстановления получите новый безопасный прикладной ответ. Изменение состояния кэша является одним подтверждением, а возвращение измерительного потока — другим. Если приложение удерживает последнее число, сохраняйте возраст и качество. Оно не должно автоматически становиться свежим только по появлению любого локального сетевого признака, не связанного с новым физическим событием на датчике.
Принять правила мониторинга
В паспорте разделите сетевой индикатор и итоговую готовность сервиса. Для тревоги сохраняйте исходное состояние и основание вывода, а не только перевод в красную лампу. Приёмка подтверждает штатные переходы, отказ и восстановление на известном узле. Это позволяет хозяйству реагировать на реальные проблемы без ложных аварий от неверной интерпретации обычного технического состояния кэша.